染色质可及性反映基因组中哪些区域能够被转录因子识别和结合,是理解基因如何在不同细胞中表达的重要线索。目前,公共数据库已经积累了大量单细胞转录组数据,但同时测量基因表达和染色质可及性的配对数据仍然有限。特别是当预测对象为训练集中未出现过的细胞或基因组区域时,现有模型也面临挑战。
10月28日,中国科学院上海营养与健康研究所人工智能与数字健康部团队在国际学术期刊Advanced Science在线发表题为“XChrom: A Cross-Cell Chromatin Accessibility Prediction Model Integrating Genomic Sequence and Cellular Context”的研究成果。该研究建立了深度学习框架XChrom,将基因组序列信息与单细胞RNA测序所反映的细胞状态相结合,用于预测不同细胞中的染色质可及性,并推断转录因子活性。
研究团队利用来自人类和小鼠的五组公开配对数据进行评估。结果显示,在跨基因组区域预测中,XChrom与序列模型scBasset表现相当;在跨细胞预测中,XChrom在多项指标上优于Seurat、MultiVI等现有模型。它还能够同时预测训练中未见过的区域和细胞,即实现“跨区域、跨细胞”预测。模型生成的数据也有助于降低染色质数据噪声、保留细胞状态特征。
研究进一步检验了模型对新样本和不同物种的适用性。在骨髓单个核细胞数据中,经过批次效应校正后,XChrom在多数分类指标上优于对照模型。团队还使用人、小鼠、猕猴和狨猴的运动皮层数据开展跨物种分析,发现分别在单一物种数据上训练的模型能够识别其他物种中的细胞类型,并捕捉进化保守的调控规律。
在COVID-19案例中,研究人员用健康供者的PBMC配对数据训练模型,再依据患者的转录组数据推断疾病相关转录因子活性。模型能够识别出训练数据中较少见的单核细胞状态,并鉴定出重症与轻症患者间活性存在差异的转录因子。这些结果为探索疾病状态相关的转录调控变化提供了新的分析工具。
研究团队已将XChrom作为开源Python软件包发布于GitHub。该研究所用数据均来自公共数据集。
中国科学院上海营养与健康研究所博士研究生苗园园为论文第一作者,王振研究员为通讯作者。该研究得到国家自然科学基金、广州国家实验室专项项目等的资助,并得到汪思佳研究员和黄涛研究员的支持与帮助。
论文链接:https://advanced.onlinelibrary.wiley.com/doi/10.1002/advs.78456
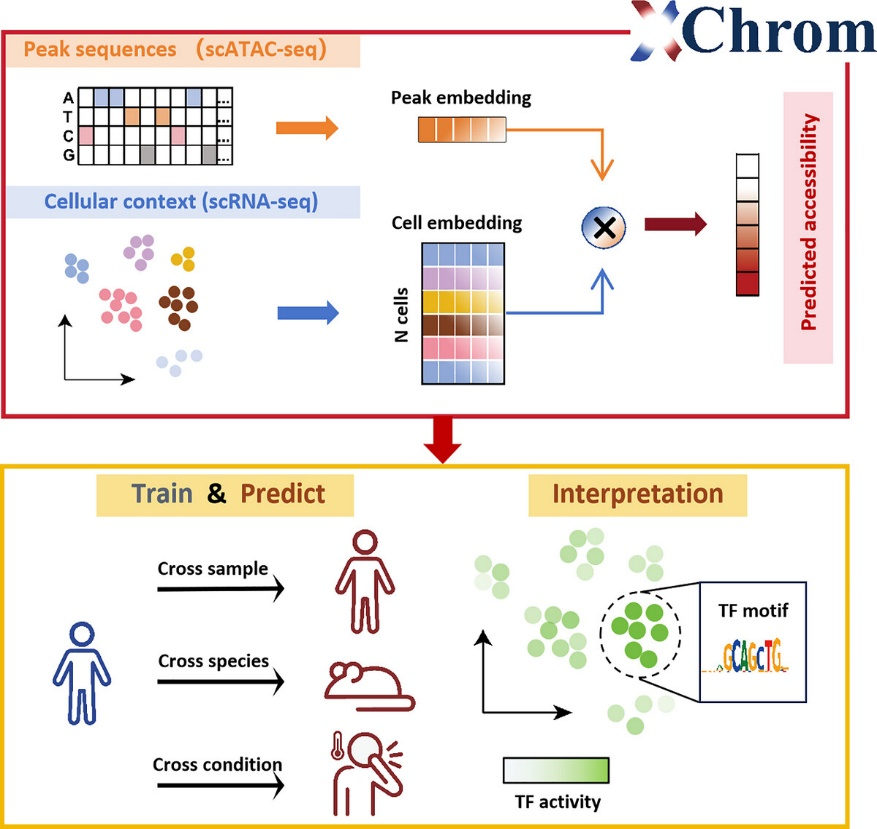
XChrom研究示意图。XChrom整合从基因组序列中提取的序列嵌入和从单细胞转录组数据中提取的细胞嵌入,实现全基因组范围的跨细胞染色质可及性预测。在预测任务中,XChrom可应用于跨样本、跨物种及不同疾病状态等场景;在可解释性分析中,XChrom可用于推断细胞特异性的转录因子活性。
推送单元:工程实验室人工智能与数字健康部、科技规划与任务处

 官方微信
